
斗篷系统爬虫误伤排查:UA与设备指纹冲突的应对路径
爬虫误伤率突然升高的根因往往不在单条UA规则,而在UA行为配置与设备指纹置信度之间的联动失效。本文按前提分支给出排查路径:什么情况下先查UA版本错配、什么情况下该校准指纹阈值、下一步检查什么,并附一个匿名团队的恢复案例。
共 31 篇相关文章
爬虫误伤率突然升高的根因往往不在单条UA规则,而在UA行为配置与设备指纹置信度之间的联动失效。本文按前提分支给出排查路径:什么情况下先查UA版本错配、什么情况下该校准指纹阈值、下一步检查什么,并附一个匿名团队的恢复案例。
爬虫UA排除模式选错会让真实访客被当成爬虫拦掉,误判率升高直接拖垮转化。本文从流量结构与部署环境两个约束条件切入,拆解UA包含与排除模式的选择逻辑,并给出缓存联动与故障排查的具体路径,适合日点击量在千级到万级之间的投放团队对照检查配置。
斗篷系统选型对比的关键不在功能列表长短,而在爬虫识别规则与缓存一致性策略能否匹配你的流量构成。本文按不同业务前提分支解答选型、UA行为配置、缓存联动排查及审核驳回后的故障路径,覆盖投放与运维环节高频疑问。
UA规则包含与排除模式常被混用,误杀真实访客或漏放审核抓取请求才暴露。本文按访客构成、审核风险和运维能力三个前提,说明两种模式何时适用、何时不适用,并给出核查路径。
多国家页面版本配置答疑针对多地区投放中的流量结构、部署环境与验收要求,逐项拆解国家维度规则、UA识别协同、缓存一致性和审核驳回应对,解决投放与运维环节高频疑问。
移动端与爬虫共用UA规则、页面版本经CDN缓存时,UA行为配置与版本错配问题易被掩盖。本文拆解UA识别、缓存同步、审核驳回与故障排查高频疑问,给出排查路径。
爬虫请求占比偏高、反向代理改写UA、误杀率敏感条件叠加时,UA行为配置的规则顺序、缓存联动与审核驳回复查成为高频疑问。本文按条件拆解并给出排查路径。
中小流量广告账户在单机部署、日均千级点击与500ms页面切换验收约束下,选型对比时最易把UA行为配置和缓存一致性疑问混在一起。本文按问答拆解关键前提,先区分流量结构、部署环境与验收要求,再逐项给出配置与排查路径,覆盖审核驳回与故障定位。
误判率突然升高是最让人头疼的故障之一——昨天还正常的访客分流,今天突然把大量真实用户判成了爬虫,或者反过来。遇到这种情况,切忌直接去改指纹阈值或UA规则
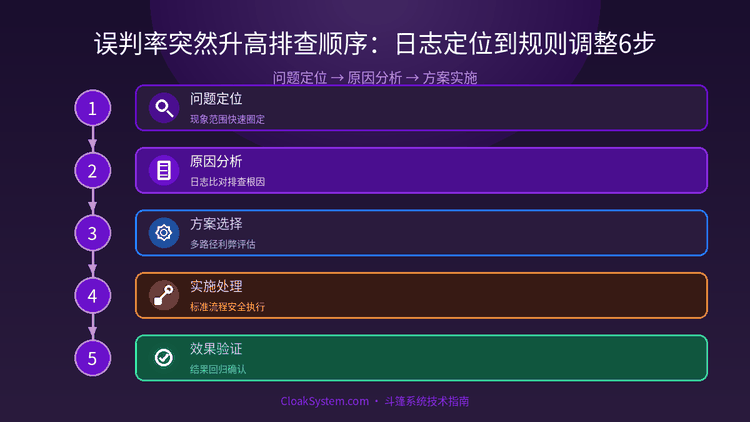
本文从爬虫识别与UA配置的组合策略出发,讲解如何通过特征分层、行为验证与规则调优降低真实用户误杀率,并给出常见误判场景的应对方法,适用于斗篷系统投放与运维环节。
