斗篷系统的技术定义
通俗定义:斗篷系统是一套根据访客身份返回差异化内容的中间层服务——搜索引擎爬虫获得利于抓取的轻量版本,真实用户获得交互完整的业务版本,两类访客各取所需。
严谨定义:斗篷系统(Cloak System)是一种基于访客身份识别与动态内容分发的服务端中间件。它通过采集HTTP请求中的用户代理(User-Agent)、IP地址、Cookie、浏览器指纹、行为特征等多维信号,利用规则引擎或机器学习模型判定访客类型(爬虫、自动化检测程序、真实用户),并将不同类别的访客分流至不同的落地页版本,从而实现面向不同访客群体的精准内容分发。
从技术架构看,斗篷系统本质上是位于Web服务器与业务应用之间的一个决策网关。它不修改业务代码,而是在请求进入业务逻辑之前完成一次“身份判定+路由选择”。判定结果决定用户最终看到哪一版页面,而这一过程对访客完全透明。
核心组件与架构
一个生产级斗篷系统由四个核心模块构成,缺一不可。
特征采集模块
特征采集模块负责在请求进入时提取可用于身份判定的原始数据。采集维度包括:
- 网络层特征:IP地址、ASN(自治系统号)、ISP信息、地理位置(国家/城市/经纬度)
- 请求头特征:User-Agent、Accept-Language、Accept-Encoding、Sec-CH-UA(客户端提示)、Referer
- 会话特征:Cookie、Session ID、历史访问频率、页面停留时长
- 行为特征:鼠标轨迹、键盘事件、滚动行为(需注入JavaScript采集)
- 环境特征:浏览器指纹(Canvas指纹、WebGL指纹、字体列表)、屏幕分辨率、时区、语言
采集时机分为两类:同步采集(请求头、IP、Cookie)在HTTP请求到达时立即完成;异步采集(行为特征、指纹)需在页面加载后通过JavaScript回传,因此斗篷系统通常采用“首屏先渲染标准页、异步判定后再跳转”的混合策略。
识别判定模块
识别判定模块是斗篷系统的“大脑”。它接收特征采集模块输出的结构化数据,执行判定逻辑。判定方式分三个层次:
- 规则匹配:基于黑名单/白名单的静态规则。例如,将已知的广告检测爬虫IP段、特定UA特征(如
AdsBot-Google、Mediapartners-Google)直接命中。 - 启发式评分:对多个特征加权打分。例如,IP为数据中心IP(+30分)、UA为无头浏览器特征(+25分)、无Cookie(+15分)、无JavaScript执行能力(+20分),总分超过阈值则判定为爬虫。
- 机器学习模型:基于历史流量训练的分类模型(如随机森林、XGBoost),输入特征向量,输出“爬虫概率”或“真实用户概率”。
生产环境中,三层判定通常串联执行:先走规则匹配快速过滤,未命中的进入评分模型,评分仍不确定的再调用机器学习模型兜底。
分流执行模块
分流执行模块根据判定结果执行实际的内容分发。常见执行方式:
- 302重定向:服务端返回302状态码,将访客引导至目标页面。实现简单,但会暴露跳转链路。
- 服务端渲染切换:在同一URL下,根据判定结果渲染不同HTML内容。对用户无感知,但要求业务代码支持模板切换。
- 反向代理转发:斗篷系统作为反向代理,将请求转发至不同的后端服务(标准页服务或完整页服务)。
分流执行模块还需处理边缘情况:判定结果不确定时默认返回标准页(稳妥优先);已判定为真实用户的访客需通过Cookie标记,避免后续请求重复判定。
规则库管理模块
规则库管理模块提供可视化的配置界面,运营人员可在此维护IP黑名单、UA规则、指纹特征库、判定阈值、分流比例等参数。规则库支持热更新,无需重启服务即可生效。同时,规则库应记录每次判定决策的日志,用于后续回溯和模型迭代。
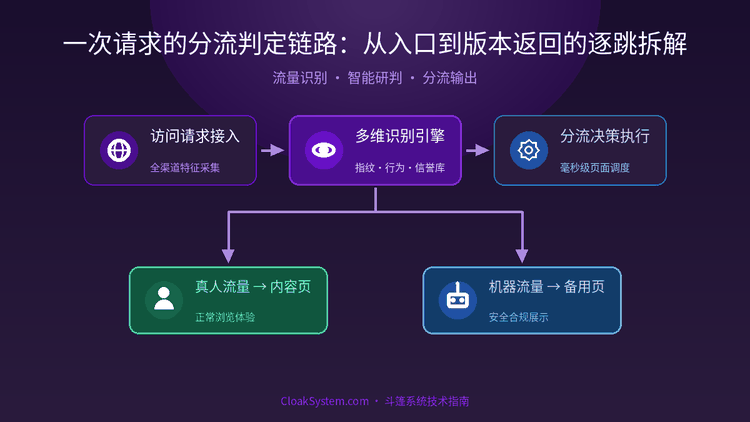
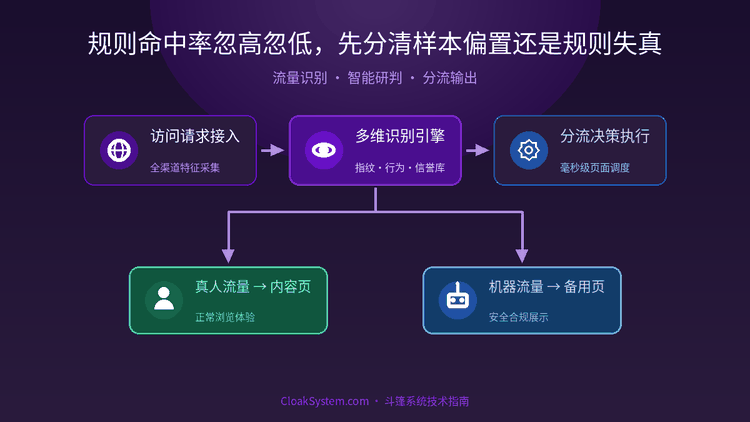
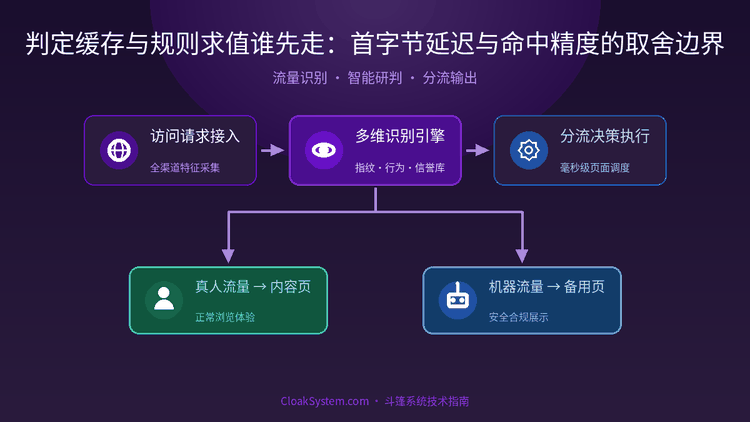
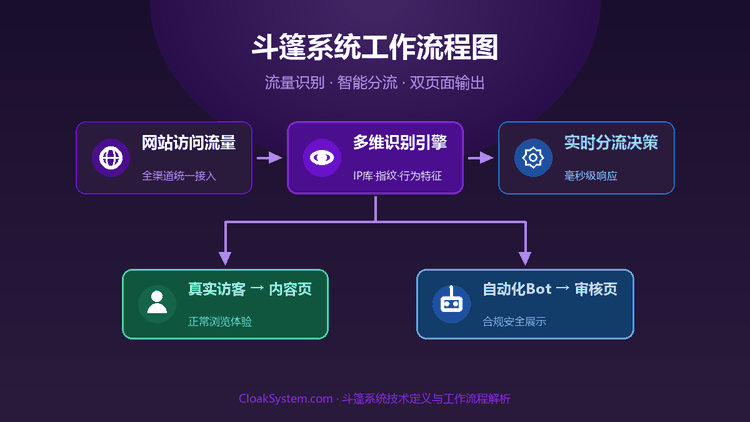
架构示意图:
BLOCK0
完整工作流程
斗篷系统的请求处理流程可拆解为四个步骤:采集 → 匹配 → 置信度 → 分流。
第一步:特征采集。用户发起HTTP请求,斗篷系统在反向代理层拦截请求,提取IP、UA、Cookie、请求头等同步特征。若页面嵌入了异步采集脚本,则首轮请求先返回一个临时页面,同时加载JavaScript采集指纹和行为数据。
第二步:规则匹配。将采集到的特征与规则库中的静态规则进行比对。例如,检查IP是否命中已知爬虫IP段(如Googlebot的IP段66.249.64.0/19),UA是否包含bot、crawler、spider等关键词。若命中高置信度规则,直接进入分流步骤。
第三步:置信度计算。未命中静态规则的请求进入评分模型。系统对每个特征赋予权重并计算总分,输出一个0-100的置信度分数。例如:数据中心IP(+30)、无Cookie(+15)、无JS执行能力(+20)、UA为Chrome 120但缺少Sec-CH-UA(+10),总分75,超过60分的爬虫阈值,判定为爬虫。
第四步:分流执行。根据判定结果,系统将请求路由至对应页面版本。真实用户获得完整版页面(业务落地页),爬虫与自动化程序获得标准版页面(轻量展示内容)。分流完成后,系统为真实用户设置标记Cookie(如cloak_uid=xxx),后续请求直接跳过判定流程。
以下为简化版流程伪代码:
BLOCK1
斗篷系统解决什么问题
斗篷系统解决的核心矛盾是:同一URL背后的不同访客群体,对页面内容的需求天然不同。
搜索引擎爬虫的抓取需求
搜索引擎与广告平台的自动化爬虫(如Googlebot、AdsBot-Google)抓取页面时,只解析服务端返回的原始HTML,不执行(或有限执行)JavaScript,也不产生交互行为。对这类访客,页面的价值在于:结构清晰、加载迅速、元数据完整、内容与链接描述一致。重交互的营销组件(弹窗、即时客服、动态表单)对爬虫毫无意义,反而拖慢抓取效率。
真实用户的浏览需求
真实用户通过浏览器访问页面,完整执行JavaScript、携带Cookie、产生滚动与点击等行为事件。他们需要的是完整的业务内容:产品细节、促销信息、转化入口、客服支持。对这类访客,页面越完整、路径越短,体验与转化越好。
差异化分发的工程价值
如果用一套页面同时服务两类访客,必然出现取舍:为爬虫精简页面会损失真实用户的转化能力,为用户堆叠营销组件又会增加页面体积、降低抓取效率。斗篷系统通过访客识别将两者解耦——为爬虫返回精简的标准版页面,为用户返回完整的业务版页面,让每类访客都获得最适合自己的内容。
典型应用场景
- 多地域内容适配:不同国家/地区的法规与语言不同,根据IP地理位置分发符合当地要求的页面版本。
- 流量来源策略隔离:同一链接面向不同渠道(社交媒体、搜索引擎、直邮)的访客,展示不同的落地页策略。
- 机器流量卸载:将已知的机器流量导向轻量页面,降低业务服务器负载与带宽成本。
合规使用的重要提示
需要明确的是:向广告平台的审核系统展示与真实投放不一致的内容,违反Google Ads、Meta Ads等主流平台的政策条款,被识别后会导致广告拒登乃至账户封禁。斗篷系统的研究价值在于理解访客识别与内容分发机制本身;在涉及广告投放的实际业务中,应当确保面向审核系统与真实用户的页面内容一致,不要将识别能力用于应对平台审核。
与相关技术的边界
斗篷系统常被与CDN分流、A/B测试、反向代理混淆,但它们在目标、判定依据和实现层级上有本质区别。
与CDN分流的区别
CDN分流基于网络位置(用户地理区域、运营商)将请求路由至最近的边缘节点,目标是降低延迟、提升访问速度。斗篷系统基于访客身份(爬虫vs真实用户)决定返回内容,目标是内容差异化。CDN不关心访客是谁,斗篷系统不关心访客在哪。
与A/B测试的区别
A/B测试将流量随机或按特征均匀分为多组,展示不同页面版本,通过数据统计确定哪个版本转化率更高。其核心目标是优化转化,分组是实验性的、临时的。斗篷系统的分流是确定性的、基于身份判定的,目标是内容适配,而非实验优化。A/B测试的分组对用户透明,斗篷系统的分流对爬虫透明。
与反向代理转发的区别
反向代理是Web服务器的通用组件,负责负载均衡、请求转发、SSL终止等。斗篷系统可以基于反向代理实现,但反向代理本身不具备身份判定能力。斗篷系统在反向代理的基础上增加了特征采集、规则匹配、置信度计算等决策逻辑,是“反向代理+决策引擎”的组合。
边界总结
| 技术 | 判定依据 | 核心目标 | 实现层级 |
|---|---|---|---|
| CDN分流 | 网络位置 | 加速访问 | L4/L7负载均衡 |
| A/B测试 | 随机/实验分组 | 优化转化 | 应用层 |
| 反向代理 | 无(纯转发) | 负载均衡/安全 | L7代理 |
| 斗篷系统 | 访客身份 | 内容差异化 | L7代理+决策引擎 |
上手路径与学习顺序
斗篷系统的学习路径应遵循“原理 → 搭建 → 配置 → 调优”的递进顺序,每一步都有明确的实践目标。
第一阶段:理解原理(1-2周)
掌握斗篷系统的核心概念:特征采集维度、判定算法、分流机制。建议先阅读技术原理详解,理解流量识别的基本逻辑和页面跳转的两种实现方式(服务端跳转与客户端跳转)。同时了解爬虫UA识别配置,掌握最基础的UA识别规则。
第二阶段:环境搭建(1周)
在本地或云服务器搭建斗篷系统运行环境。推荐参考Nginx+PHP部署指南,该指南覆盖了Nginx配置、PHP-FPM调优、HTTPS证书部署等关键环节。若需面向生产环境,可进一步阅读服务器选型方案,了解服务器配置要求和负载均衡方案。
第三阶段:规则配置(1-2周)
在搭建好的环境中配置规则库。学习如何设置IP黑名单、UA规则、Cookie策略。重点掌握Cookie池隔离方案,理解Cookie隔离在降低账号关联风险中的作用。同时配置AB页跳转指南中的跳转参数,确保标准页与完整页之间的切换逻辑正确。
第四阶段:调优与进阶(持续)
根据实际流量数据调优判定阈值和规则权重。学习浏览器指纹配置指南,引入Canvas指纹、WebGL指纹等高级特征。关注移动端适配方案,处理移动端Safari与Chrome在指纹采集上的差异。最后,通过缓存一致性策略解决缓存导致的误判问题。
小结
斗篷系统是访客识别与内容分发领域的一项技术方案,其核心价值在于通过身份判定实现内容差异化分发。它由特征采集、识别判定、分流执行、规则库管理四个模块构成,工作流程可归纳为“采集→匹配→置信度→分流”四步。与CDN分流、A/B测试、反向代理等技术的本质区别在于,斗篷系统的判定依据是访客身份而非网络位置或实验分组。
学习斗篷系统应遵循“原理→搭建→配置→调优”的路径,每个阶段都有明确的实践目标和参考文档。需要特别注意的是,斗篷系统的使用必须遵守所在地区的法律法规和广告平台政策,其技术能力不应被用于应对法律监管或实施欺诈行为。
延伸阅读
- Cookie池隔离实战
- 分流阈值设定方法论
- 流量分流的适用边界
- 反向代理原理辨析
- 访客请求全链路时序拆解
- 广告平台违规流量识别机制
- 斗篷系统合规使用边界
- 从IP黑名单到浏览器指纹
- 斗篷系统核心术语
- 斗篷系统替代方案
- 流量识别链路时延优化
- Cookie池隔
- 访客分层采样验证时序
- 无指纹样本冷启动分流取舍
- 规则条件短路顺序调优
- 风险标记TTL调优
- 日志采样率配置
- 回源IP与访客出
- 会话播种链路详解
- 动态阈值取舍
- 分流采样率调优的边界
- 分流判定链路拆解
- 页面版本绑定Co
- 访客识别置信度校准
常见问题
斗篷系统是否违反广告平台政策?
斗篷系统本身是一种访客识别与内容分发技术,但用它在广告投放中向审核系统隐藏真实页面内容,被Google Ads、Meta Ads等主流平台的服务条款明确禁止,被识别后通常直接封禁账户。本站内容定位于技术研究:理解机制原理是合法且有价值的,但把它用于应对平台审核属于高危行为,请务必区分技术学习与实际投放的边界。
斗篷系统与普通跳转有什么区别?
普通跳转(如302重定向)对所有访客一视同仁,跳转逻辑不区分访客身份。斗篷系统的跳转是基于身份判定的条件跳转——爬虫跳转到标准页,真实用户跳转到完整页。判定逻辑是斗篷系统的核心,而普通跳转没有这一层。
斗篷系统的使用存在哪些合规风险?
主流广告平台(Google Ads、Meta Ads等)的服务条款明确禁止向审核系统展示与真实投放不一致的内容,一旦被识别,轻则广告拒登,重则账户永久封禁。若进一步将技术用于向监管或审核系统隐藏违规内容,还可能触及所在地法律法规的红线。建议将斗篷系统作为访客识别与内容分发机制来学习研究,实际投放业务中保持面向各方的页面内容一致,从源头降低合规风险。
斗篷系统需要单独部署服务器吗?
生产环境建议独立部署。斗篷系统需要处理特征采集、判定计算、分流执行等逻辑,若与业务服务器共用资源,可能影响判定速度和稳定性。独立部署可参考高可用部署架构,推荐2核4G以上配置,并启用负载均衡。
移动端斗篷系统配置有哪些特殊注意事项?
移动端的主要差异在于浏览器指纹采集的兼容性。iOS的Safari对Canvas指纹有严格的隐私限制,返回的指纹数据噪声较大;Android的Chrome则相对宽松。此外,移动端需额外采集设备型号、操作系统版本、屏幕尺寸等特征。具体适配方案可参考双端差异处理要点。