Cloak(斗篷)技术是数字营销领域的核心技术之一,其本质是通过识别访问者身份,为不同类型的访问者展示不同的页面内容。本文从技术原理层面,深度解析Cloak斗篷系统的工作机制。
一、Cloak技术的基本原理
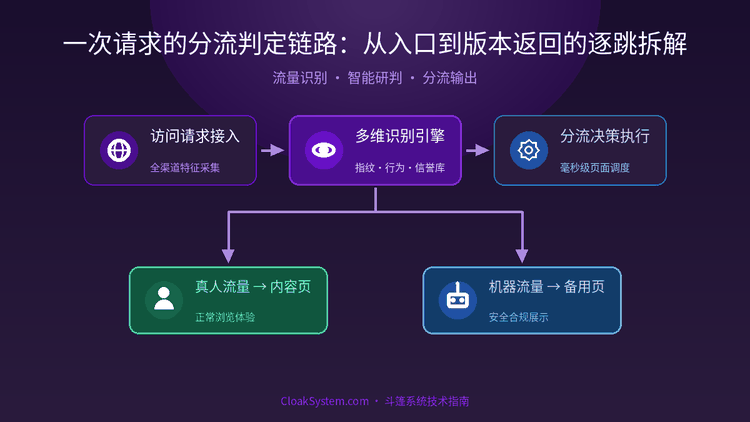
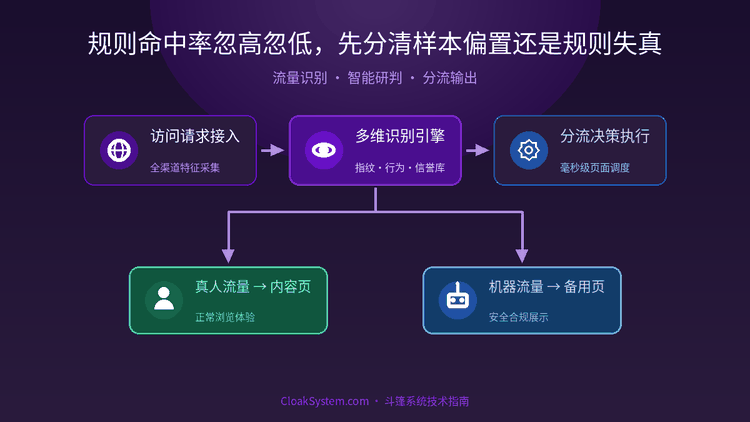
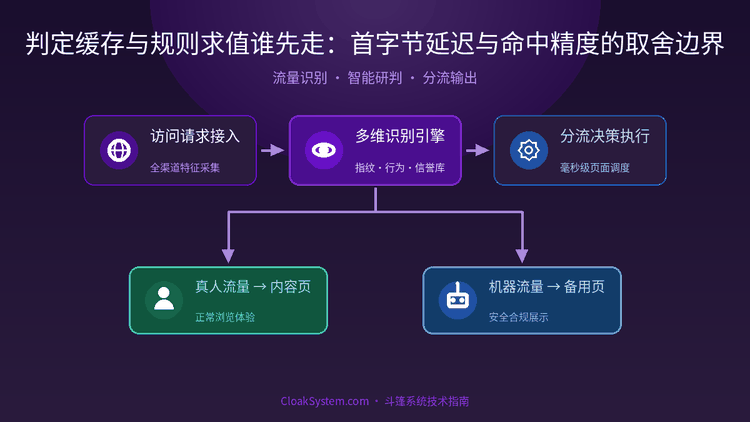
Cloak技术的核心流程可以概括为三个步骤:识别 → 判断 → 分发。
- 识别:收集访问者的各项特征数据(IP、UA、Referer、设备指纹等)
- 判断:将特征数据与规则库匹配,判定访问者类型
- 分发:根据判定结果,返回对应的页面内容
整个过程在服务端完成,对访问者完全透明。想要了解Cloak技术更深入的分析,推荐阅读 Cloak技术深度解析。
二、流量识别机制
流量识别是Cloak技术的核心,识别准确率直接决定斗篷效果。主要的识别维度包括:
1. IP地址识别
这是最基础的识别方式。通过维护广告平台检测IP库,可以识别出:
- 搜索引擎蜘蛛(Baiduspider、Googlebot等)
- 广告平台审核团队IP
- 数据中心IP(可能是爬虫或检测工具)
- 代理服务器IP
2. User-Agent识别
UA字符串包含浏览器、操作系统等信息。通过分析UA可以识别:
- 爬虫UA(包含bot/spider/crawler等关键词)
- 模拟器UA(与真实设备存在细微差异)
- 异常UA(格式不标准或与已知设备不匹配)
3. 行为特征识别
真实用户与自动化检测程序的行为模式存在差异:
真实用户:有鼠标移动、滚动、点击等交互行为,停留时间不一
自动化检测程序:直接访问URL,无交互行为,停留时间短或固定
审核人员:有交互但行为模式与普通用户不同(如快速检查多个区域)
4. 设备指纹识别
通过Canvas指纹、WebGL指纹、字体列表等技术,生成访问者的设备唯一标识,可以识别同一设备的重复访问。
三、页面跳转逻辑
Cloak系统的页面跳转逻辑通常采用规则引擎实现,支持灵活的规则配置:
跳转规则示例
- 规则1:IP在检测IP库中 → 返回A页
- 规则2:UA包含bot关键词 → 返回A页
- 规则3:Referer来自广告平台 → 返回B页
- 规则4:设备指纹匹配已知审核设备 → 返回A页
- 默认规则:无法判断 → 返回A页(安全优先)
规则引擎支持优先级配置,按优先级从高到低匹配,命中即执行。
四、技术方案对比
当前主流的Cloak技术实现方案有三种:
方案1:服务端跳转
在Web服务器(Nginx/Apache)层面通过Lua或PHP脚本实现跳转,详见页面跳转插件开发实战。
- 优点:速度快、对用户无感、难以被前端检测
- 缺点:规则配置不够灵活、需要服务器权限
方案2:客户端跳转
通过JavaScript在浏览器端判断并跳转。
- 优点:可获取更丰富的客户端信息、配置灵活
- 缺点:有跳转延迟、可能被广告平台检测到JS代码
方案3:混合方案(推荐)
服务端做初步识别(IP/UA),客户端做深度识别(行为/指纹),两层过滤。
- 优点:识别准确率最高、兼顾速度与灵活性
- 缺点:实现复杂度高、维护成本较高
更多技术方案的对比分析,可参考 Cloak技术分类文档。
以上三种跳转方案在商用产品与自建实现中的能力差异,可进一步参考开源自建方案对比,判断当前团队能否以零预算覆盖核心链路。
五、部署与维护
部署架构
生产环境的Cloak系统建议采用独立部署:
- 独立服务器部署跳转服务,与业务服务器分离
- 使用CDN加速A页加载,确保审核时页面快速响应
- 数据库存储IP库与规则配置,支持热更新
- 日志系统记录所有访问与跳转记录,便于分析优化
日常维护
- 每周更新检测IP库
- 每月分析跳转日志,优化规则配置
- 监控通过率变化,及时调整策略
- 定期测试A页与B页的可访问性
六、总结
Cloak斗篷技术的核心在于精准的流量识别与灵活的页面跳转。通过多维度识别、规则引擎判断、混合跳转方案,可以构建高准确率、高稳定性的斗篷系统。技术方案的选择需根据实际场景与资源情况灵活调整。
延伸阅读
原理之外,跳转环节的检测应对实战同样关键:页面跳转怎么检测应对?最新检测应对策略和实战经验。
- Cookie池隔离实战
- 分流阈值设定方法论
- 流量分流的适用边界
- 开源自建斗篷维护成本
- 自建斗篷与商用服务对比
- 反向代理原理辨析
- 访客请求全链路时序拆解
- 广告平台违规流量识别机制
- 斗篷系统合规使用边界
- 从IP黑名单到浏览器指纹
- 斗篷系统核心术语
- 斗篷系统替代方案
- 流量识别链路时延优化
- Cookie池隔
- 访客分层采样验证时序
- 无指纹样本冷启动分流取舍
- 规则条件短路顺序调优
- 风险标记TTL调优
- 日志采样率配置
- 回源IP与访客出
- 会话播种链路详解
- 指纹置信度阈值调优
- 分流采样率与指纹
- Cookie播种
- 动态阈值取舍
- 分流采样率调优的边界
- 分流判定链路拆解
- 页面版本绑定Co
- 访客分层判定权重配置
- 访客识别置信度校准
常见问题
斗篷技术识别流量的核心维度有哪些?
主要包含四个维度:IP地址(识别搜索引擎蜘蛛、广告平台审核团队、数据中心和代理服务器IP)、User-Agent(识别爬虫、模拟器和异常UA)、行为特征(真实用户有鼠标移动和点击交互,自动化检测程序直接访问URL且停留时间短)、设备指纹(通过Canvas、WebGL和字体列表生成设备唯一标识)。
页面跳转规则引擎是如何工作的?
规则引擎按优先级从高到低匹配,命中即执行。典型规则包括:IP在检测IP库中返回A页、UA包含bot关键词返回A页、Referer来自广告平台返回B页、设备指纹匹配已知审核设备返回A页。默认规则是安全优先,无法判断时返回A页。
三种Cloak技术方案分别有什么优缺点?
服务端跳转(Nginx/Apache层用Lua或PHP实现)速度快、对用户无感、难以被前端检测,但规则配置不够灵活;客户端跳转(JavaScript判断)可获取更丰富信息且配置灵活,但有跳转延迟且可能被检测到JS代码;混合方案(推荐)服务端做IP/UA初步识别、客户端做行为/指纹深度识别,准确率最高但实现复杂度高。
生产环境部署Cloak系统有哪些建议?
建议独立服务器部署跳转服务,与业务服务器分离;使用CDN加速A页加载确保审核时快速响应;数据库存储IP库与规则配置并支持热更新;日志系统记录所有访问与跳转记录。日常维护需每周更新检测IP库、每月分析跳转日志优化规则、监控通过率变化。
如何区分真实用户与自动化检测程序的行为差异?
真实用户有鼠标移动、滚动、点击等交互行为,停留时间不一;自动化检测程序直接访问URL,无交互行为,停留时间短或固定;审核人员有交互但行为模式与普通用户不同,如快速检查多个区域。通过行为特征识别可有效提升判断准确率。