这篇东西我们系统性拆一下分流判定超时到底怎么落地。
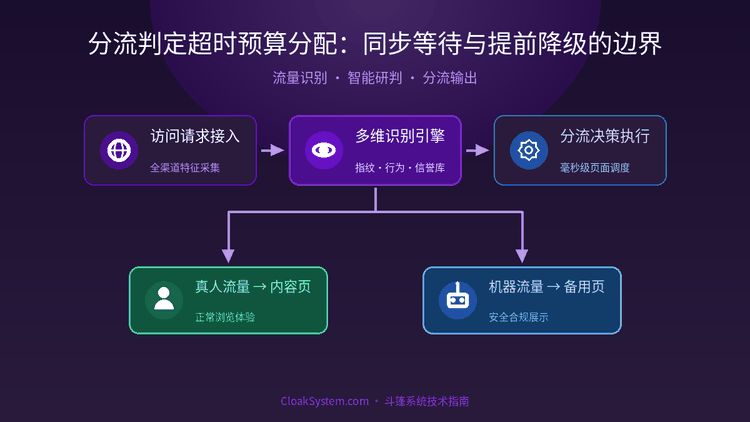
上个月有个做教育投放的客户找过来,情况挺典型的。日均点击一万出头,机器就一台4核8G,上面跑着Nginx加PHP-FPM。他们的分流判定链路里串了三个环节:UA解析、IP库查询、指纹采集。验收标准写得很清楚——首访请求从进到出,P95不能超过800毫秒。上线之后监控面板上时不时冒尖刺,1.2秒,页面倒是出来了,可用户早划走了。这事儿跟某个环节慢关系不大,主要问题出在整条判定链路的超时预算压根没分配,每个环节各自等各自的,超时叠超时,兜底页永远赶不上趟。所以今天要聊的核心就一个:分流判定超时的预算,怎么在同步等待和提前降级之间切分。
先定判断标准:超时预算不是拍脑袋定的数
我见过太多人配超时就是随手写个500毫秒,问他为什么,答不上来。其实超时预算的分配得先看三个约束条件:
- 链路总预算:从请求进入系统到返回页面,用户能感知的等待上限。广告落地页这个场景,经验上700到1000毫秒是分水岭,超过之后跳出率明显往上走。
- 环节数量与最坏时延:判定链路串了几个环节,每个环节在极端情况下的耗时上限是多少。同步环节越多,预算被摊得越薄。
- 降级可接受度:提前降级意味着用默认页面版本兜底,这个兜底页的转化损失能不能接受。高客单页面损失大,低客单页面损失小。
这三个约束定下来,才能算每个环节分多少毫秒。我的习惯是先看链路再分预算,别反过来先设超时再倒推链路,那样很容易翻车。
同步等待与提前降级:两种方案的条件对比
判定链路的超时处置,说白了就两条路:要么继续等,要么不等了直接降级。
同步等待的适用条件
同步等待适合那些判定信号必须完整才能出结果的场景。比如访客分层权重依赖三个信号交叉验证,缺一个信号判定置信度就掉到阈值以下,这时候提前返回的默认版本大概率是错的,还不如多等几十毫秒拿准确结果。
但同步等待有个硬约束:总预算必须留足。如果链路总预算是800毫秒,UA解析占200,IP查询占150,指纹采集占300,剩下150毫秒给降级兜底,这个分配是紧的。任何一个环节波动,兜底就没时间执行了。同步等待的代价就是兜底空间被压缩。
提前降级不是等到超时才降,而是在链路中途设检查点。比如第一个环节返回后,已经用掉400毫秒,剩余预算不足以支撑后续两个环节的最坏时延,这时候就该主动降级,而不是硬着头皮往下走。判定逻辑可以写成这样:BLOCK0
这里的"兜底保留"是关键参数。兜底页的返回也需要时间,通常留50到100毫秒。不留这个余量,降级动作本身就会超时。
两种方案的核心差异
同步等待赌的是环节稳定,提前降级赌的是兜底页够用。前者适合信号强耦合的判定,后者适合信号可分离、单信号就能出大致结果的场景。
选择边界:什么条件下用哪种
边界不在技术本身,在业务对判定准确率和响应速度的权重分配。
拿那个教育客户的例子来说,他们最开始是全链路同步等待,总预算设了1200毫秒,觉得宽裕。实际上UA解析偶尔要400毫秒,IP库查询在冷启动时能到500毫秒,两个一叠加,指纹环节还没跑就已经超了。后来改成两段式:UA和IP查询同步跑,合并结果后如果已经超过500毫秒,直接走降级;没超过就继续跑指纹。降级页用的是上一轮投放中转化率中等的版本,不算最优但能接住流量。调整后P95落到620毫秒,尖刺基本消失。
这个案例的边界条件很清楚:
- 当单环节最坏时延占总预算30%以上时,同步等待的风险就高了,应该设检查点。
- 当兜底页与最优页的转化差距在20%以内时,提前降级的代价可控。
- 当流量结构以首访为主时,判定链路没有缓存可依赖,超时预算要更保守。老访客有Cookie或指纹缓存,链路短,预算可以松一些。
反过来说,如果兜底页转化差距超过30%,或者业务明确要求判定必须完整,那就得压缩环节数量而不是压缩超时。把串行改并行,或者把部分环节挪到异步,给同步链路腾预算。
配置层面的落地细节
超时预算分配不是写死在代码里的,得做成可调参数。
- 总预算:按广告平台类型分档,搜索流量给700到900毫秒,展示流量给500到700毫秒。
- 环节超时:每个环节设独立超时,建议不超过总预算的35%。
- 检查点位置:放在耗时波动最大的环节之后,通常是IP库查询或指纹采集。
- 降级标识:降级返回的页面要带上标识头,方便日志里区分正常判定和降级兜底的比例。
监控上盯两个指标:降级率和降级后的页面转化率。降级率持续高于5%,说明同步等待环节太慢,得优化;降级后转化率掉得厉害,说明兜底页选得不对,得换。顺带提一句,超时预算和采样率是联动的。采样率调高,指纹采集环节的队列变长,耗时会涨,超时预算就得跟着调。这两者得放在一起看。
小结
分流判定超时的预算分配,核心是在同步等待和提前降级之间找平衡点。判断标准看链路总预算、环节最坏时延和兜底可接受度。同步等待适合信号强耦合的场景,但要留足兜底空间;提前降级适合信号可分离的场景,代价是兜底页的转化损失。选择边界取决于单环节时延占比、兜底页转化差距和流量结构。配置上把总预算、环节超时、检查点位置都做成可调参数,监控降级率和降级转化率来反推调优。
常见问题
分流判定超时设多少毫秒比较合适?
这个要看链路串了几个环节和兜底页的加载速度。搜索流量一般700到900毫秒,展示流量可以收紧到500到700。但别只盯总预算,每个环节也要设独立超时,不然一个慢环节把预算吃光,后面全得降级。
提前降级会不会导致页面版本频繁切换?
要看降级触发频率。如果检查点设得太靠前,动不动就降级,用户看到的页面版本确实会跳来跳去。一般建议检查点放在耗时波动最大的环节之后,而且降级后要有一段缓存期,别让同一个访客反复触发降级。说白了,降级是兜底,不是常态。
同步等待和提前降级能混用吗?
能,而且实际部署里多数是混用的。前面的轻量环节同步跑,重环节之前设检查点,预算够就继续,不够就降。关键是检查点的判定逻辑要写清楚,剩余预算算错的话,降级也来不及。
超时预算分配和服务器配置有关系吗?
有,但关系没那么直接。服务器配置影响的是单环节的处理速度,配置高环节快,超时预算可以松一点。不过更关键的是链路设计,串行改并行比堆配置见效快。如果服务器已经到瓶颈了,先看进程池和连接数,再调超时预算。
延伸阅读
超时预算的分配逻辑和PPC广告的出价预算分配有相似之处,都是在一个总盘子里切分资源,读这篇可以补充预算切分的思路:PPC广告预算分配与分流系统超时预算的异同