本文系统性拆解等于没记的完整实操要点。
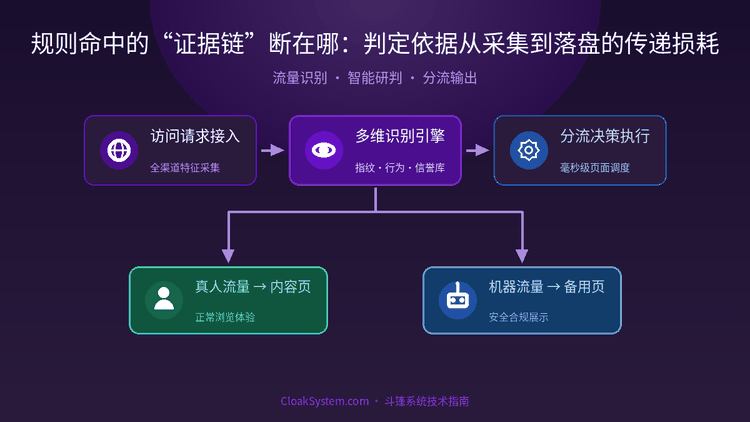
规则命中不准,十有八九不是规则写错了,而是判定所依据的那份"证据"在链路中途被截断或改写了。上个月一个做教育投放的团队反馈:后台看某条关键词分支命中率不到两成,可他们手工用同样的UA和Cookie去请求,十次有八次能进。规则没动、阈值没动,差的就是证据在传递途中丢了东西。这篇把"证据链"拆开看:一条请求的判定依据从哪采、经过谁、最后写成什么样,哪几个环节最容易断,断了以后怎么补。
证据链的四段传递:从采集到落盘
先把链路摆清楚。一条请求要完成一次规则命中,判定依据大致走四段:
- 采集段:从请求头、Cookie、URL参数、客户端指纹脚本里取原始信号。
- 归一化段:把原始值转成规则可比对的形式,比如UA转小写、IP归到网段、时间戳转时区。
- 求值段:规则引擎拿归一化后的字段做条件比对,得出命中或未命中。
- 落盘段:把命中结果连同"当时用了哪些字段"写成日志或快照。
问题在于,很多团队只盯第三段。规则引擎本身逻辑清晰、单测也过,可前两段采到的字段在传递中被裁剪,第四段写日志时又只记了结果没记依据,于是命中率对不上时根本无从复现。这就是证据链的传递损耗。
有一个容易被忽略的细节:归一化段是有损的。UA转小写会丢掉大小写差异,IP归网段会丢掉末段,时间戳转时区会丢掉原始偏移。这些损耗在单条请求上无所谓,但当规则条件恰好依赖被丢掉的那部分时,命中就会系统性偏移。
采集段最常断在字段裁剪
采集段的问题通常不是"采不到",而是"采了没传下去"。常见三种断法:
- 请求上下文裁剪过早。为了压首字节延迟,在入口层就把请求体、部分请求头丢掉,只留几个核心字段。规则若依赖被丢的字段,求值段只能走默认值。
- 异步补采与同步判定错位。指纹脚本异步回传,判定却同步执行,首访请求拿不到指纹,只能按"无指纹"分支走。这类断法在首访占比高的账户里特别明显。
- 多级代理改写请求头。Nginx到PHP-FPM之间若有多层转发,X-Forwarded-For、User-Agent可能被中间层覆盖,采到的已不是访客原始值。
排查时别急着调规则,先把一条真实请求在采集段实际产出的字段清单打出来,和规则条件里引用的字段逐个对,缺哪个补哪个。这一步和访客识别参数改动里讲的核对逻辑是一回事,只不过对象从参数换成了证据。
求值段的"默认值"会呈现为命中
求值段最隐蔽的问题是默认值。规则条件引用了一个字段,字段缺失时引擎不会报错,而是按预设默认值参与比对。默认值选得随意,就会出现"看起来命中了、其实证据是空的"。
举个典型配置:设备类型字段缺失时默认"desktop",结果一批移动端首访因为指纹未就绪被判成桌面,进了桌面版分支。日志上显示命中,实际是默认值在替真实信号做决定。
处理原则是把"字段缺失"和"字段有值"分开表达。规则里显式写一条"字段不存在则走兜底"的分支,比依赖引擎默认值可控得多。字段缺失时判定链怎么回退,请求头字段缺失时有更细的分支拆法,可以对照着把默认值逐项审一遍。
落盘段只记结果不记依据,等于没记
第四段的损耗最伤排查效率。日志里只写"命中分支B",不写"当时UA是什么、Cookie有没有、指纹置信度多少",事后根本判断不了这次命中是规则起效还是默认值兜底。
落盘段要保留的最小依据集,建议是:参与求值的字段名与归一化后的值、字段是否缺失的标记、命中的规则ID、求值耗时。不必全量落原始请求,但每个参与判定的字段都得有"当时值"或"当时缺失"的明确记录。
这里有个取舍:全量落盘写放大严重,条件采样又可能漏掉异常样本。日志采样的取舍边界在斗篷系统跳转日志里拆过,核心思路是"结果日志可采样、证据快照不采样",两者分开配置。
一个复盘:命中率对不上,最后补的是快照
某金融投放团队,日均请求量中等,规则链十几条分支。他们发现某条高价值分支命中率连续几天偏低,规则没改过。按上面四段逐段核对:采集段字段齐全,求值段规则逻辑无误,问题出在落盘段——日志只记了分支ID,没记指纹置信度。
进一步查发现,指纹脚本版本升级后回传变慢,首访请求在求值段拿到的置信度是空值,按默认走了一条保守分支。因为日志没记这个字段,前三天一直以为是规则问题,反复调阈值。补上证据快照后,一次就定位到了脚本时序。修复动作很简单:判定前对指纹置信度缺失做显式分支,同时把置信度写进快照。
这类"证据在求值前就缺了"的情况,和一次请求的版本决策里讲的快照字段取舍是同一类问题,只不过那次是字段选多了拖慢判定,这次是字段没记导致无法复盘。
小结
规则命中失准,先把证据链四段过一遍:采集段有没有裁剪、求值段有没有默认值替真实信号做决定、落盘段有没有留下依据。规则本身往往是最后才需要动的。补齐顺序建议从落盘段往前推——先让每次命中可复现,再谈调优。
常见问题
规则命中日志和后台统计对不上,先查哪一段?
先查落盘段。看日志里有没有记录参与判定的字段值,没有的话统计口径本身就不可信。说白了,结果对不上很多时候是两边算的根本不是同一批证据。
字段缺失时走默认值,算不算规则命中?
算命中,但属于"证据不足型命中",统计上应该单独标出来。否则默认值兜底的量会混进真实命中里,把命中率抬高。这个要看情况,如果默认分支占比高,规则本身的区分度就值得怀疑了。
证据快照要保留多久?
至少覆盖一个完整的调优观察窗口,通常和转化回传窗口对齐。窗口内的快照能支撑复现,窗口外的留结果日志即可。顺带说一句,我一般还会把快照按规则版本打标,回滚时好对照。
异步补采的指纹没回来,这条请求还能判定吗?
能判,但要显式走"指纹未就绪"分支,别让它落进默认值。首访占比高的账户,这条分支的流量不小,配置时要单独设阈值和兜底策略。
多级代理下请求头被改写,证据以哪一层为准?
以最靠近访客的那一层采集值为准,并在归一化段标记来源层。中间层改写后的值只能作辅助,不能替代原始证据参与求值。
延伸阅读
证据链的求值段其实对应规则引擎的决策树执行顺序,想看清条件比对在引擎内部怎么走,可以读这篇:规则编排引擎决策树执行链路。