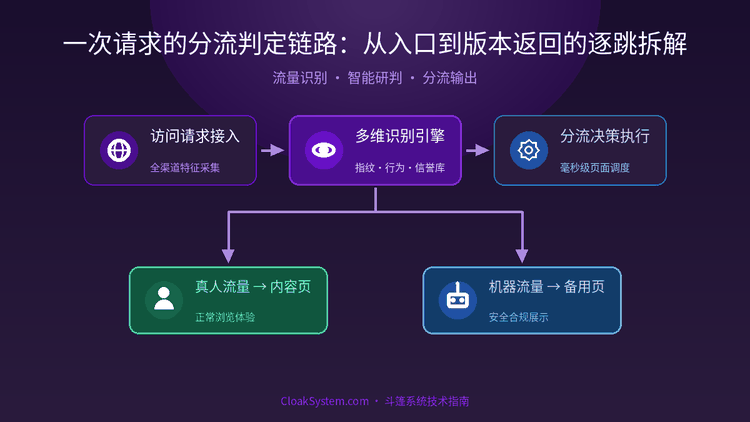
斗篷系统的核心在于“识别”与“分发”的配合:识别不准,分流就失去意义;识别过严,又会让正常流量大量流失。而采样率与动态分流阈值正是决定这一平衡的关键旋钮。很多从业者把精力放在规则写法或指纹维度上,却忽略了采样率与阈值之间的联动关系,导致系统在流量波动时要么误杀过多,要么漏放明显异常。本文从识别置信度分级出发,拆解采样率如何影响阈值收敛方向,并给出可操作的调优路径。
采样率与阈值:一对必须联动的参数
采样率指的是系统对访客进行深度检测的比例——例如设置为 30%,意味着只有三成流量会走完整的指纹、行为及环境检测流程,其余七成直接按默认规则放行。动态分流阈值则是判定“是否触发跳转”的分数门槛,当检测结果分数超过阈值时执行跳转。两者看似独立,实则共享同一个目标:在最小化误判的前提下最快识别风险访客。
采样率过高,检测开销变大,页面响应时间上升,同时也会提升误判概率(因为深度检测会暴露出更多普通用户的“非预期”特征);采样率过低,则大量风险流量跳过检测,直接看到真实页面。常见的做法是初始采样率设置在 20% 到 40% 之间,但更关键的是,采样率必须与阈值一起调整,而不是单独调某一个。
置信度分级:让阈值有据可依
动态阈值不应是一个固定数字,而应基于识别结果的置信度分级来定义。常见的分级逻辑可分为三层:
- 高置信风险(例如指纹匹配、UA异常、行为特征高度一致):这部分流量应触发跳转,阈值通常设定在 0.8 以上。
- 中置信可疑(部分特征匹配,但存在矛盾项):这类流量应进入二次验证,比如要求执行一个简单的JavaScript挑战,或临时增加采样率进行重检。
- 低置信正常(无异常特征或极少匹配):直接放行,阈值在 0.3 以下。
阈值调优的目标是让三个区间尽可能分离,避免重叠。当采样率提高时,系统能收集到更多特征,置信度分布会变宽,此时应同步提高高置信阈值(例如从 0.75 升至 0.85),以抵消因特征增多带来的误判风险。反之,采样率降低时,检测信号减少,置信度分布会收窄,阈值应适当下调,避免漏判。
动态阈值收敛:让系统自我调节
静态阈值无法适应流量波动。动态阈值收敛是让系统根据近期识别结果自动调整阈值的过程,典型实现是:每 N 个请求周期(例如每 1000 次检测),统计当前阈值下的通过率与跳转率,若通过率过高(例如超过 85%),则上调阈值;若跳转率过高(超过 30%),则下调阈值。收敛目标是让通过率维持在 70% 到 80% 之间,这个区间能平衡误杀与漏放。
实际操作中,收敛的步长不宜过大。建议每次调整幅度不超过 0.05,并且要设置上下限(例如 0.2 到 0.95),防止系统因异常流量冲击而过度震荡。另外,收敛周期应避开广告流量高峰时段,否则容易把临时波动误判为长期趋势。
与缓存策略的联动:避免阈值空转
动态阈值依赖实时检测数据,但缓存会截断数据流。如果缓存命中率过高,系统看到的“置信度样本”只来自未命中缓存的流量,这会产生幸存者偏差。例如,你可能把高风险 IP 段写入了缓存白名单,导致这些流量不再经过检测,而阈值基于剩余流量收敛,结果越来越严格,最终误伤正常用户。
因此,建议将缓存与阈值调优隔离:只统计未命中缓存的样本,或者为缓存流量单独设置一个较低阈值(例如默认放行),避免污染动态收敛计算。关于缓存策略的更深入讨论,可参考动态内容缓存要点。另外,若你正在用回源 IP 检测作为识别维度,其配置同样会影响采样率与阈值的有效性,建议阅读回源检测实战以了解常见坑点。
调优步骤与配置示例
以下是一套可复用的调优流程,适用于 Nginx + PHP 环境的通用配置:
- 设置初始采样率为 30%,阈值高置信 0.8、中置信 0.5、低置信 0.3。
- 运行 24 小时,统计各置信度区间的流量占比与跳转率。
- 若高置信区间跳转率低于 50%,说明阈值过高或采样率不足——可先提高采样率至 40%,再观察高置信区间是否扩大。
- 若中置信区间占比超过 30%,说明特征区分度不够,应优化识别规则而非调阈值。
- 收敛周期设为每 5000 次检测,调整步长 0.03,上下限 0.2-0.95。
配置示例(Nginx 变量传递 + PHP 逻辑):
BLOCK0
BLOCK1
注意,采样率必须对爬虫或明显机器人请求设为 100%,否则它们会漏过检测。UA 识别策略的具体配置可参考爬虫UA识别配置。
小结
采样率与动态分流阈值是斗篷系统中最容易被低估却影响最大的两个参数。它们不是独立调节的旋钮,而是一套联动系统:采样率决定系统“看”多少,阈值决定“信”多少。合理的调优路径是:先定置信度分级,再设置初始阈值,然后基于收敛周期动态调整,同时通过缓存隔离避免数据污染。只要掌握这套联动逻辑,即便流量波动剧烈,系统也能保持稳定的通过率与跳转率平衡。
延伸阅读
若你想了解采样率与阈值调优在实际投放中对成本和风险的整体影响,这篇《斗篷技术是否值得使用:成本与风险全解析》能帮你从决策层面评估调优投入的回报边界。
常见问题
初始采样率和阈值应该怎么设置?
建议初始采样率设为 30%,高置信阈值 0.8、中置信 0.5、低置信 0.3。运行 24 小时后统计各置信度区间的流量占比与跳转率,再根据实际数据调整。注意采样率必须对爬虫或明显机器人请求设为 100%,否则它们会漏过检测。
采样率和阈值为什么要联动调整,不能单独调一个?
采样率决定系统“看”多少流量,阈值决定“信”多少检测结果。采样率提高时,系统收集到更多特征,置信度分布变宽,此时应同步提高高置信阈值(例如从 0.75 升至 0.85),以抵消因特征增多带来的误判风险;采样率降低时则相反,阈值应适当下调,避免漏判。
动态阈值收敛的周期和步长怎么配置?
建议每 5000 次检测作为一个收敛周期,每次调整幅度不超过 0.05(文中示例为 0.03),并设置上下限 0.2 到 0.95。收敛目标是让通过率维持在 70% 到 80% 之间——若通过率超过 85% 则上调阈值,若跳转率超过 30% 则下调阈值。收敛周期应避开广告流量高峰时段。
缓存命中率过高会怎样影响阈值调优?
缓存会截断检测数据流,如果缓存命中率过高,系统只基于未命中缓存的流量收敛阈值,产生幸存者偏差。例如高风险 IP 段被写入缓存白名单后不再经过检测,阈值基于剩余流量收敛会越来越严格,最终误伤正常用户。建议只统计未命中缓存的样本,或为缓存流量单独设置较低阈值(如默认放行)。
中置信区间占比超过 30% 说明什么问题?
说明特征区分度不够,应优化识别规则而非调阈值。中置信可疑流量指部分特征匹配但存在矛盾项,这类流量占比过高意味着你的置信度分级三个区间重叠严重,需要先提升特征维度的区分能力,再考虑调整阈值参数。