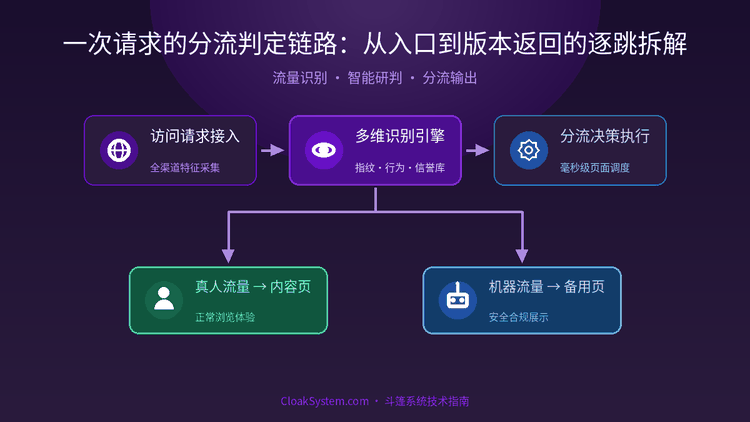
这篇文章想聊的是分流决策链路到底怎么一步步走完的。上个月有个做教育投放的客户,问了个特别具体的问题:同一个广告组进来的两个访客,设备型号一样,来源渠道也一样,凭什么一个拿到标准页、另一个拿到完整页?他就想知道,决策到底是在哪一步分岔的。这问题问得挺到位,因为它逼着我们把「分流」从结果倒着推回过程。下面我们就沿着一次请求从入口到版本返回的完整链路走一遍,看看每一步的输入是什么、判断依据是什么、输出又交给了谁,顺带说清楚哪一环最容易成为改写结果的地方。
入口层:请求先被削成什么形状
请求打到系统入口的时候,信息其实是过量的。完整链路的第一步,说白了还轮不到判断,得先决定把哪些字段带进决策。这一层的输入是原始请求:URL、查询参数、请求头、Cookie、来源地址。输出是一份裁剪后的请求上下文。裁剪规则通常包括这些:白名单保留关键头(UA、Accept-Language、Referer),查询参数只留语义相关的几个,请求体视方法而定是否读取。
这里有个容易搞混的点:裁剪顺序会影响后续判断。比如说参数解析排在头解析之前,而且解析失败就直接中断,那一个畸形参数就能让整条链路拿不到任何判定依据。我的习惯是各字段独立解析、失败降级为空值,别整体中断。入口层还承担一个隐性职责:给这次请求打上追踪标识。没这个标识,后面每一跳的输出没法串联,出了问题只能靠猜。
判定层:信号按什么顺序被读取
请求上下文准备好之后,才进入真正的判定环节。这一步的输入是上一步的裁剪结果,输出是一个版本标识,或者一个兜底标记。判定一般按「先廉价后昂贵」的顺序读信号:Cookie 里的会话标识最便宜,缓存里已有的判定结果更便宜,设备指纹采集最贵。所以合理排序是缓存 → Cookie → 指纹 → 行为特征。这个顺序在指纹采样窗口与同里有更细的讨论,此处不展开。
每一步的判断逻辑本质上是条件求值:命中某组条件就短路返回,不命中就继续下一层。这里最怕的是条件之间互相覆盖——前一步刚判定为 A 版本,后一步一个更宽的条件又把它改写成 B。这类问题在规则链短路顺序配置里有过完整复盘,核心结论是:决策型条件必须排在过滤型条件之后,且一旦命中就应终止求值。
缓存里要是有这个访客的判定结果,判定层直接返回,链路到这儿就结束了。未命中时才走完整求值。这意味着缓存 TTL 实际上决定了「一次判定能用多久」,TTL 太长会让版本调整滞后生效,太短则回源压力上来。这个边界的定法属于分流判定缓存穿透的范畴。
动作层:版本标识怎么变成一次跳转
判定层输出的是抽象标识,动作层负责把它翻译成具体的响应动作。输入是版本标识加请求方法,输出是状态码、响应头、响应体。这里的分岔在于跳转方式。返回 302 意味着浏览器再发一次请求,跳转目标由 Location 头决定;返回 JS 跳转意味着响应体里带一段脚本,由客户端执行。两者的差异不只是延迟,还有参数传递的可靠性——302 的查询参数跟随 Location,JS 跳转则依赖脚本拼接,任何一处转义出错都会导致参数丢失。
动作层还有一个常被低估的职责:保证同一次判定在整条跳转链上不被改写。如果跳转目标本身又触发一次判定,而且两次判定的输入有细微差异(比如 Referer 变了),就可能出现版本漂移。稳妥的做法是在跳转 URL 上带上一次性的版本凭证,让目标页直接采信。
返回层:响应离开系统前的最后一道检查
响应构造完成到真正发出之间,还有一层容易被跳过的检查。输入是待发响应,输出是最终响应。这一层要核对三件事:响应头里的缓存指令是否与判定结果一致(缓存了错误的版本会很麻烦)、状态码与跳转方式是否匹配(302 配空 Location 是典型事故)、响应体是否被中间层压缩或改写。中间层包括反向代理和 CDN,它们对响应头的处理策略可能和源站预期不一致。
我见过一个团队踩过的坑:源站返回 302,但 CDN 把 Location 里的查询参数过滤掉了,结果目标页收到的参数不全、判定回退到默认版本。他们查了两天才定位到是 CDN 的参数白名单问题。这类问题的排查顺序可以参考部署后跳转不生效,思路都是从响应侧往源站倒推。
哪一环最容易被改写
把整条链路摊开看,改写风险最高的其实是层与层之间的交接处,判定层反倒没那么危险。判定层输出标识、动作层翻译标识、返回层核对响应,每一处交接都依赖一个隐式约定:字段名一致、类型一致、空值语义一致。约定一旦漂移,结果就在没人注意的地方变了。
所以调优的优先级应该是:先保交接处的一致性,再谈判定逻辑的精细度。判定再准,交接丢了字段也白搭。
常见问题
分流决策链路一般有多长
看系统设计。轻量实现可能只有入口裁剪加一次条件求值,两三跳就结束。完整实现会包含缓存查询、指纹采集、动作翻译、响应核对,五六跳很常见。链路长短本身不决定好坏,关键是每一跳的代价是否和它带来的判定收益匹配。
为什么同一访客两次请求拿到不同版本
多半是缓存 TTL 和判定输入不一致共同造成的。第一次请求写入了缓存,第二次请求的某个输入字段变了(比如 Referer 或某个参数),缓存键跟着变,于是走了完整求值,结果就可能不同。这个要看情况,先确认缓存键包含哪些字段。
跳转方式会影响判定结果吗
严格说不会直接影响判定,但会影响判定结果能否完整传递到目标页。302 和 JS 跳转在参数传递上的可靠性不同,参数一丢,目标页的二次判定就会回退。说白了,判定没错,是搬运过程出了岔子。
入口裁剪会不会把有用信息裁掉
会,而且这种损失是静默的。裁掉的字段不会报错,只会让后续判定少一个依据。稳妥做法是裁剪规则和判定规则一起评审,判定用到的字段必须在白名单里。顺带说一句,我一般还会在入口层留一个原始请求的采样副本,出问题时能对照。
响应核对这层能省掉吗
不建议省。这层的开销很小,但能拦住缓存指令错配、状态码与跳转方式不匹配这类低级事故。省掉它,问题就会推迟到线上才暴露,排查成本高得多。
延伸阅读
想从更宏观的视角理解这套链路在整个系统里的位置,可以接着读这篇关于斗篷技术体系构成的梳理。