本文系统性拆解规则引擎预编译的完整实操要点。
上个月一个做教育投放的客户来问,说他们分流系统的规则库已经堆到两百多条,最近每次改一条关键词跳转条件,从保存到全量生效要等两三分钟,投放同事在群里催得急。他们的第一反应是把规则引擎改成预编译模式,觉得编译一次跑得快,热更新慢点也能忍。问题恰恰出在这里:预编译确实压低了单次判定的开销,但它把规则变更的代价从毫秒级推到了分钟级,而他们日均规则改动十几次,这笔账算下来并不划算。规则引擎预编译与即时解释之间的选择,本质上是判定延迟与规则热更新代价之间的一次取舍,没有普适答案,只有边界条件。
先定判断标准:看规则变更频率与判定量级的比值
选型不要一上来就比性能数字,先算一个比值:单位时间内的规则变更次数,除以单位时间内的分流判定请求数。这个比值越高,越应该偏向即时解释;越低,预编译的收益才越明显。
具体拆开看三个变量:
- 规则变更频率:一天改几次规则。投放调整期可能一天十几次,稳定期可能一周一次。
- 判定请求量级:日均请求是几千还是几十万。量级越大,单次判定省下的微秒越值钱。
- 规则复杂度:条件分支嵌套几层、正则和指纹比对占多少。复杂度越高,预编译省下的重复解析越多。
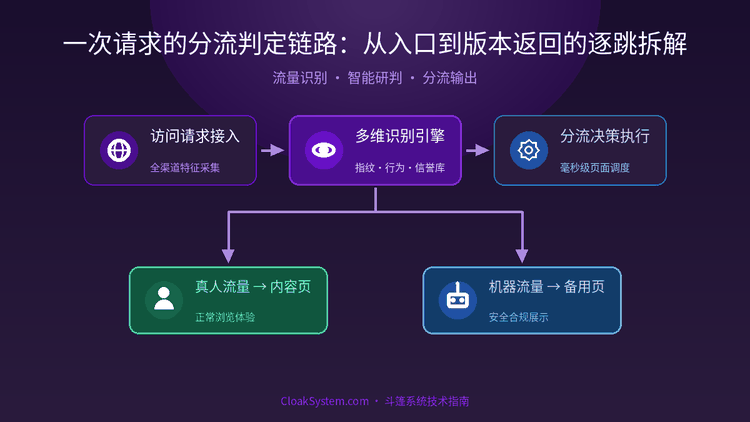
一个粗略的经验边界:如果一天改规则超过五次,而单次判定延迟还在可接受范围内,优先保热更新的即时性;如果规则一周不动一次、日均判定几十万起,预编译带来的稳定延迟收益才值得为它付出重载成本。这里说的延迟,指的是从请求进来到版本返回这一段,和请求入口到版本返回里拆解的逐跳链路是同一口径,别把后端渲染时间混进来算。
两种方案在不同条件下的表现
预编译:把解析成本前置,换取判定路径的确定性
预编译的做法是在规则保存时把条件树解析成可执行结构,判定时直接跑,不再做语法解析和条件展开。它的优势在判定路径上很干净:单次判定延迟低且波动小,P99 不会被某条复杂正则拖出长尾。
代价有两块。一是重载成本,规则一改就得重新编译并替换生效结构,两百条规则编译加校验,几十秒到几分钟都正常。二是内存占用,编译后的结构通常比原始规则文本占更多常驻内存,规则库大的时候要留意进程内存水位。
适合的场景比较明确:规则库稳定、判定量大、对延迟抖动敏感的高客单投放。预生成与实时判定在承接路径上的差异,可以参考预生成与实时判定对比里的边界讨论,思路是相通的。
即时解释:变更零等待,但判定路径带解析开销
即时解释在每次判定时读取规则并求值。好处是改完即生效,没有编译窗口,规则库版本切换也简单,回退就是换回旧文本。
代价是每次判定都要付出解析和求值开销,规则越复杂越明显;而且延迟分布容易出长尾,某条规则写得低效,会直接体现在部分请求上。规则链求值次数翻倍这类问题,在规则链条件分组后里有具体的排查路径,即时解释模式下这类开销是每次判定都实打实付的。
选择边界:三条可操作的分界线
把上面的条件收成三条边界,配置时对着卡:
- 变更频率边界:日均规则改动超过五次,且改动集中在投放高峰时段,选即时解释或带增量编译的混合模式。
- 判定量级边界:日均判定低于一万,预编译省下的延迟对整体体验影响有限,没必要为它引入重载窗口。
- 规则复杂度边界:规则里正则、指纹比对、多级嵌套占比高,预编译收益放大;规则以简单字段比对为主,两种模式差距不大,优先选运维简单的。
混合模式值得单独提一句:按规则分组,稳定组预编译、实验组即时解释,热更新只重载变动的那一组。代价是引擎要维护两套执行路径,配置复杂度上升,适合有专职运维的团队。规则分组阈值怎么定,规则链条件分组策略里有分组开销的取舍分析,可以对照着设。
一次投放团队的调整复盘
某做金融投放的小团队,规则库一百五十条左右,日均判定两三万,原来用即时解释,判定延迟中位数还行,但高峰期 P99 偶尔冲到几百毫秒,排查下来是几条正则规则在拖。他们没有直接上全量预编译,而是先做了一件事:把规则按变更频率分成稳定组和实验组,稳定组占七成、一周改不了一次,实验组三成、天天调。稳定组改成预编译、保存时编译一次,实验组保持即时解释。调整后高峰期长尾明显收敛,规则改动仍然即改即生效。踩过的坑是第一次分组分错了,把几条高频改的关键词规则划进了稳定组,结果每次改都要等编译,后来按最近三十天的改动记录重新分组才顺。这个案例的启发是,取舍不必二选一,按变更频率切分规则集往往比整体换引擎更划算。
小结
规则引擎预编译与即时解释的取舍,判断标准是规则变更频率与判定量级的比值,比较条件是重载成本对判定延迟收益,选择边界落在变更频率、判定量级与规则复杂度三条线上。规则库稳定、判定量大就偏预编译;改动频繁、量级一般就偏即时解释;两头都占的,按变更频率分组做混合。别为了单次判定的几微秒,把投放同事等规则生效的几分钟搭进去。
常见问题
规则引擎预编译后改规则要等多久生效?
看规则库大小和编译校验的严格程度,一百多条规则一般几十秒,几百条加上依赖校验可能到几分钟。这个窗口内新规则不生效,所以投放高峰前改规则要留出提前量。
即时解释模式判定延迟一定更高吗?
不一定,规则简单、以字段比对为主的时候,两种模式差距很小。说白了延迟高低主要看规则写得复不复杂,正则和嵌套多,即时解释的解析开销才明显。
规则库多大才值得上预编译?
没有固定条数,关键看判定量。日均判定几万以下,预编译的收益基本被重载成本抵消。顺带说一句,我一般还会看规则变更频率,一周不动一次的库,条数少也值得编译。
混合模式会不会让排查变复杂?
会。两套执行路径意味着日志里要能区分命中来自哪一组,否则出问题定位会绕。建议在判定日志里带上规则组标识,排查时先看组再看规则。
规则热更新期间旧规则还会命中吗?
预编译模式下替换生效结构通常有一个极短的切换窗口,切换前已进入判定的请求仍走旧结构。这个窗口一般不影响结果一致性,但如果规则改动涉及跳转目标,建议在低峰期发布并做一次回归核验。
延伸阅读
规则引擎选型只是分流系统的一环,如果想把斗篷系统与常规竞价投放的定位差异一并理清,可以接着读这篇:斗篷系统与PPC广告投放的差异对比。